Disaster Recovery
|
Данный функционал недоступен в StarVault, поставляемом в составе Nova Container Platform. |
Репликация Disaster Recovery (DR) предназначена для защиты вашего хранилища от катастрофического сбоя всего кластера, помогает упростить процесс восстановления и свести к минимуму время простоя.
Единица репликации — кластер. Первичный кластер хранит эталонные данные и передает их на вторичный. Вторичный — резервный кластер: полная копия хранилища вместе с локальными данными (токенами, арендами). Он не обслуживает клиентов (кроме распечатывания и небольшого набора служебных операций) и ждет повышения роли, чтобы принять нагрузку при отказе первичного.
К первичному кластеру можно подключить только один вторичный кластер. Кластер может находиться в одном из трех состояний:
-
роль первичного
-
роль вторичного
-
отключенная конфигурация DR
На вторичном кластере доступны только операции администрирования и управления DR-репликацией.
|
При включении роли вторичного и при смене назначенного первичного кластер полностью очищает пользовательские данные во встроенном хранилище Raft. Затем начинается синхронизация с первичным кластером. |
Операции доступны через веб-интерфейс, HTTP API и CLI.
Важные условия:
-
Для настройки DR-репликации кластер должен использовать встроенное хранилище Raft.
-
Операции по настройке и администрированию DR выполняются в корневом пространстве имен (
root).
1. Отличие от высокой доступности
Режим высокой доступности (HA) защищает от отказа узлов внутри одного кластера Raft. Узлы делят одно хранилище и выбирают активного лидера. Порядок развертывания HA приведен в статье Установка в режиме высокой доступности. Устройство встроенного хранилища описано в статье Встроенное хранилище.
В отличии от высокой доступности репликация DR защищает от отказа всего кластера. Вторичный кластер — отдельный кластер со своим хранилищем. Он получает поток данных с первичного кластера.
2. Предварительные условия
Для настройки репликации DR выполните следующие требования:
-
развернуты два кластера StarVault одной версии. Один станет первичным (основным), второй — резервным
-
оба кластера инициализированы и распечатаны. Порядок распечатывания приведен в статье Запечатывание и распечатывание хранилища
-
на обоих кластерах настроено встроенное хранилище Raft
-
у токена есть привилегии, достаточные для операций репликации. Часть операций требует возможности
sudo
|
Оба кластера должны работать на одной версии StarVault. После понижения роли исходного первичного кластера на него нельзя реплицировать данные с кластера более новой версии. Хранилище StarVault не гарантирует обратную совместимость данных. |
2.1. Требования к политике
Если вы не используете корневой токен, назначьте политике как минимум следующие пути:
path "sys/replication/dr/primary/enable" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/primary/secondary-token" {
  capabilities = ["create", "update", "sudo"]
}

path "sys/replication/dr/secondary/generate-public-key" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/primary/demote" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/secondary/enable" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/secondary/generate-operation-token/*" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/secondary/promote" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/secondary/update-primary" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/secondary/operation-token/delete" {
  capabilities = ["create", "update"]
}

path "sys/replication/dr/primary/disable" {
  capabilities = ["create", "update"]
}
3. Порядок работы
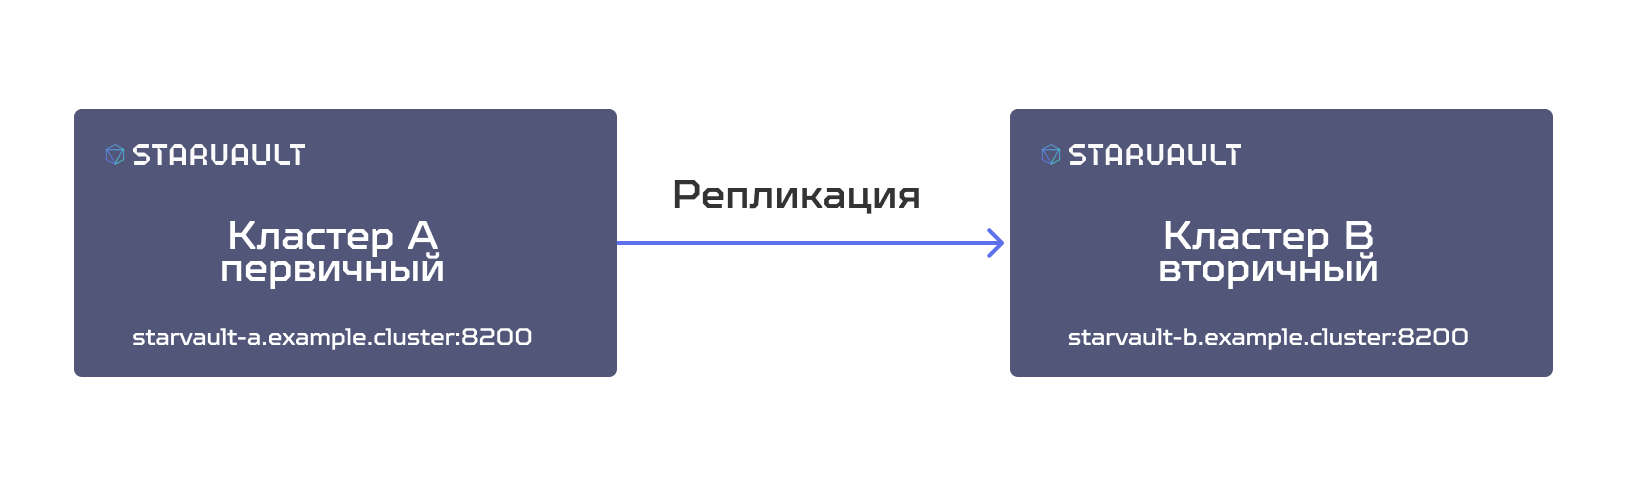
Базовая настройка репликации DR состоит из следующих шагов:
-
Включите роль первичного на основном кластере.
-
При необходимости сформируйте открытый ключ на вторичном кластере.
-
Сформируйте токен активации вторичного кластера и включите роль вторичного на резервном кластере.
-
Проверьте статус репликации на обоих кластерах.
Порядок команд приведен в статье Настройка репликации DR.
3.1. Отказ первичного кластера
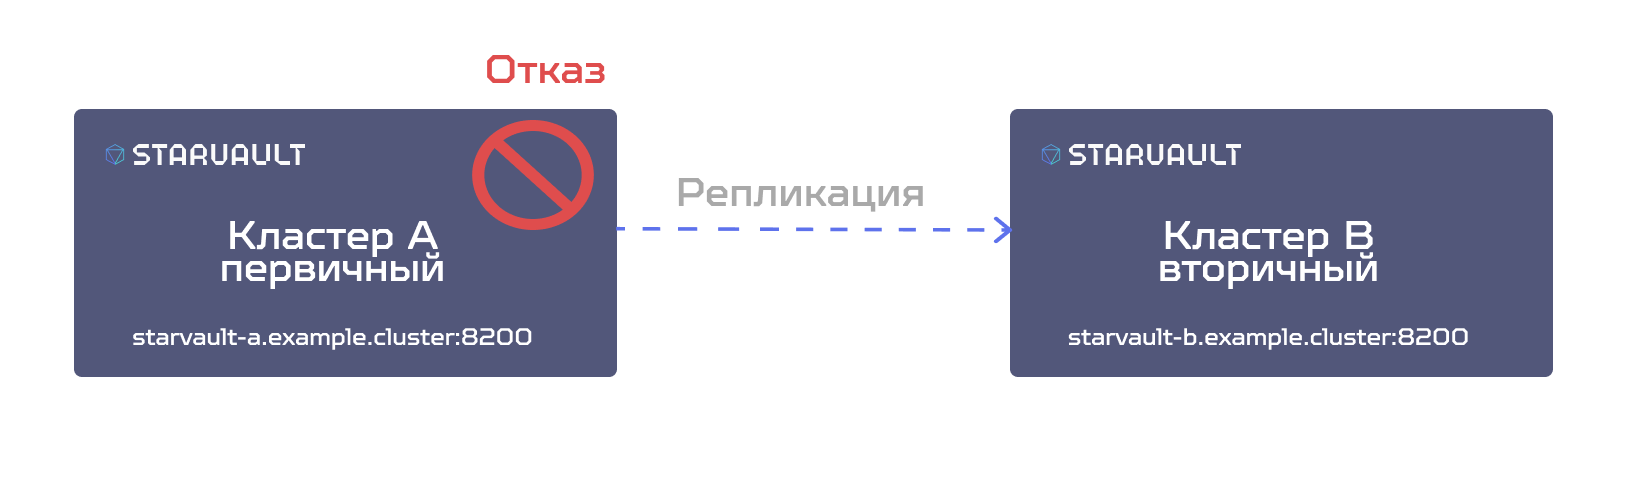
При отказе первичного кластера повысьте роль вторичного кластера. Процедура приведена в статье Повышение роли вторичного кластера DR до первичного.
После повышения роли вторичного исходный первичный кластер может снова начать принимать запросы. Тогда работают два независимых первичных кластера, и наборы данных могут расходиться. Администратор решает, что делать с каждым кластером. Рекомендуем понизить роль того первичного кластера, который был недоступен, и подключить его как вторичный, либо отключите на нем репликацию DR. После понижения роли при необходимости верните исходную топологию.
4. Расхождение данных при двух первичных кластерах
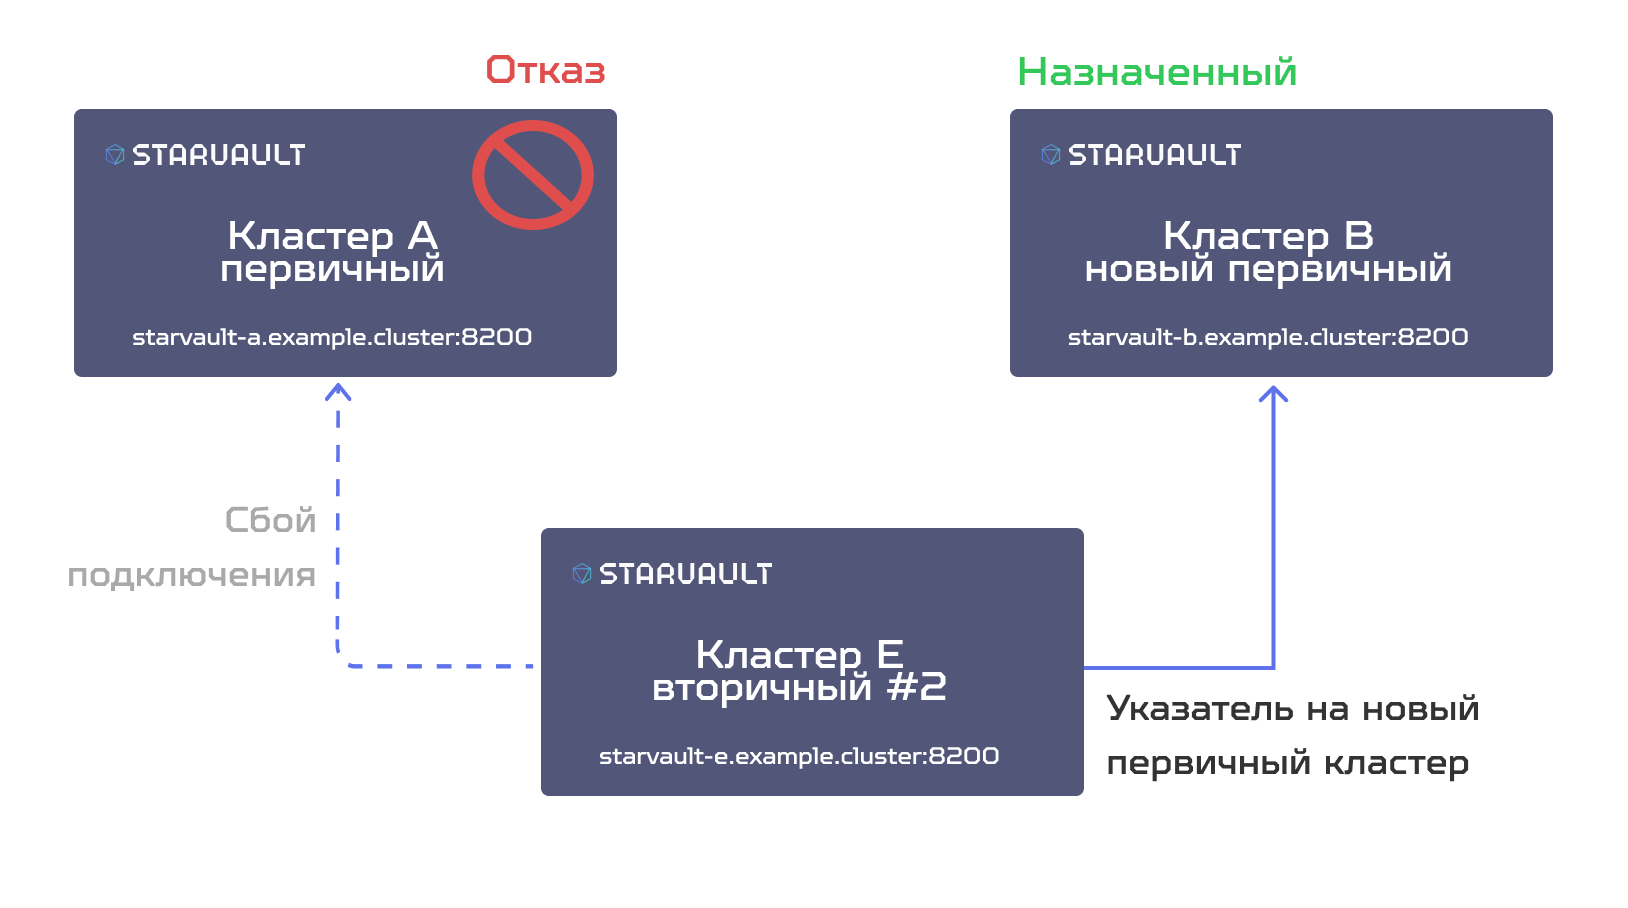
В паре репликации DR только один кластер должен выполнять роль первичного. Если исходный первичный кластер снова начинает обслуживать запросы после повышения роли вторичного, в работе оказываются два независимых первичных кластера. Записи на каждой стороне не реплицируются на другую: наборы данных расходятся, а данные на исходном первичном устарели относительно нового первичного.
|
StarVault не повышает роль вторичного кластера автоматически. Автоматическое переключение не выполняется. Администратор сам оценивает причину недоступности и принимает решение о повышении роли. |
Чтобы вернуть исходный кластер в работу, выполните одно из действий:
-
понизьте его роль и назначьте новый первичный
-
отключите на нем репликацию DR
После подключения восстановленного кластера как вторичного можно вернуть исходную топологию. Порядок приведен в статье Возврат к исходной топологии.